审稿人打开一篇投稿,摘要读起来四平八稳,方法部分逻辑闭合,讨论段落面面俱到,却找不到一处具体的实验细节、一句带个人判断的表述。这种稿件在近两年越来越常见,问题不在于它写得差,而在于它写得太「完整」——完整到看不出有谁真正对它负责。absent-author 就是针对这种状态做的一套工具:它不判断文本是否由模型生成,而是围绕「这篇论文背后有没有一个承担责任的人」整理证据、给出可复核的线索。
它把「没有作者」拆成三类可核对的痕迹
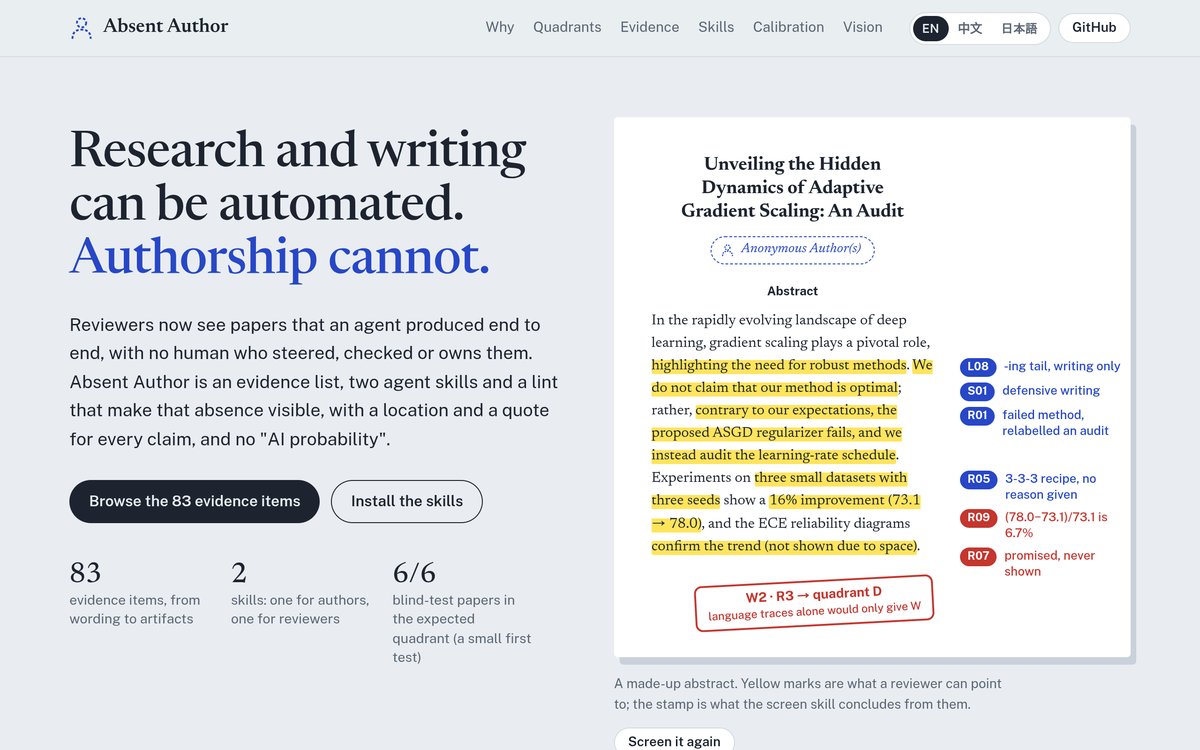
工具的核心是一份 evidence list(证据清单),清单把可疑论文的特征归到三个方向:Nobody polished it、Nobody steered it、Nobody checked it。这三句不是修辞,而是三类可以逐条比对的具体迹象——文字层面缺少打磨痕迹,研究方向缺少人为取舍的痕迹,事实与引用缺少被核查过的痕迹。清单本身是公开维护的,任何人都可以提交新的证据条目,仓库里也留了 Propose evidence 的入口,让这份判断标准随实际案例一起演进。
这一点决定了它和常见的「AI 检测器」走的是两条路。检测器输出一个概率分数,分数高了你也不知道下一步该看哪里;证据清单输出的是条目,审稿人拿着条目回原文逐条验证,能验证的留下,验证不了的剔除。判断权始终在使用者手里,工具只负责把该看的点摆出来。
两个 skill 怎么在审稿流程里分工
清单之外,absent-author 提供两个 agent skill,分别对应流程里的两个动作。paper-slop-screen 做初筛:把一篇稿子过一遍,按清单给出命中情况,适合在大量投稿进入正式评审之前先跑一轮,把明显缺少人工痕迹的挑出来。paper-author-pass 走的是另一侧:检查一篇论文是否具备「有作者负责」应有的特征,用于确认哪些稿件可以正常进入评审。
两个 skill 共用同一份证据清单,这是它设计上比较关键的一点——筛查标准和放行标准来自同一套定义,不会出现「筛的时候按一套、评的时候按另一套」的割裂。它们以 agent skill 的形式分发,主题标签里能看到 claude-code、codex 这类运行环境,意味着它被设计成嵌入已有的 agent 工作流,而不是另起一个独立平台。
| 组件 | 作用 | 在流程中的位置 |
|---|---|---|
| evidence list | 公开维护的可核对证据条目 | 判断标准的来源 |
| paper-slop-screen | 按清单筛查稿件命中情况 | 投稿初筛 |
| paper-author-pass | 检查是否具备真人负责特征 | 进入评审前的确认 |
它明确不做什么,比它做什么更值得看
作者在说明里专门写了 What this is not 和 It can be misused 两节,还留了一句 Text proves less and less。这是清醒的表态:文本层面的证据会越来越不可靠,任何单点特征都不足以定论一篇论文的性质。工具不承诺「识别出 AI 论文」,只承诺把证据摆出来供人判断。这种自我限制在同类项目里并不常见,多数工具倾向于把检测包装成确定性的结论。
它用 Python 写成,MIT 协议,仓库在开发者社区积累了 113 个 star。这个量级说明它目前是面向研究与审稿场景的小众工具,不是通用内容检测产品。它解决的问题很窄——论文背后有没有一个承担责任的人——但在这个窄范围里,它给出的东西是可操作的。
三个能直接落地的用法
期刊或会议的投稿初筛,是最直接的场景。把 paper-slop-screen 接进收稿后的自动流程,先跑一遍清单,输出命中条目而非分数,编辑按条目决定哪些稿子需要额外确认,哪些直接进入正常评审。相比人工逐篇读摘要判断,这一步省下的是通读时间,留下的是可追溯的判断依据。
文献综述阶段同样用得上。检索到一批结果后,用 paper-author-pass 检查候选文献是否具备真人负责特征,把明显缺少核查痕迹的条目降权或排除,避免把不可靠的结论引进来。这一步的价值不在于筛掉多少篇,而在于让纳入标准变得可写、可复现。
证据清单本身也可以单独用。即使不跑 skill,把清单当作一份审稿检查表,逐条对照手里的稿件,也能把「读着不对劲」这种模糊感受转化成具体条目。对于需要给出书面评审意见的场合,这比写一句「疑似 AI 生成」要有说服力得多。
absent-author 适合需要为论文判断留下依据的审稿与文献筛选场景,不适合想要一个「AI 检测分数」直接下结论的用法——它给的是证据,不是判决。
FAQ:常见问题
absent-author 和常见的 AI 文本检测器有什么区别?
常见检测器输出一个概率分数,absent-author 输出的是可逐条核对的证据条目,围绕「没人润色、没人把关、没人核查」三类痕迹展开。它不判断文本是否由模型生成,而是判断论文背后有没有一个承担责任的人,判断权留给使用者。
paper-author-pass 和 paper-slop-screen 需要一起用吗?
两个 skill 共用同一份证据清单,分别对应筛查和放行两个动作。paper-slop-screen 用于投稿初筛挑出缺少人工痕迹的稿件,paper-author-pass 用于确认稿件是否具备真人负责特征,按流程需要单独或组合使用都可以。
相关文章
AI迅搜
找工具,快人一步