网页抓取最麻烦的地方往往不是第一次把数据拿到手,而是页面改版后脚本集体失效。Scrapling 把这一点当成核心问题来解:它是一个用 Python 写的自适应抓取框架,定位覆盖从单次请求到全站爬取的完整范围,BSD-3-Clause 协议开源,在开发者社区有相当高的关注度。
自适应抓取:页面改版后少改代码
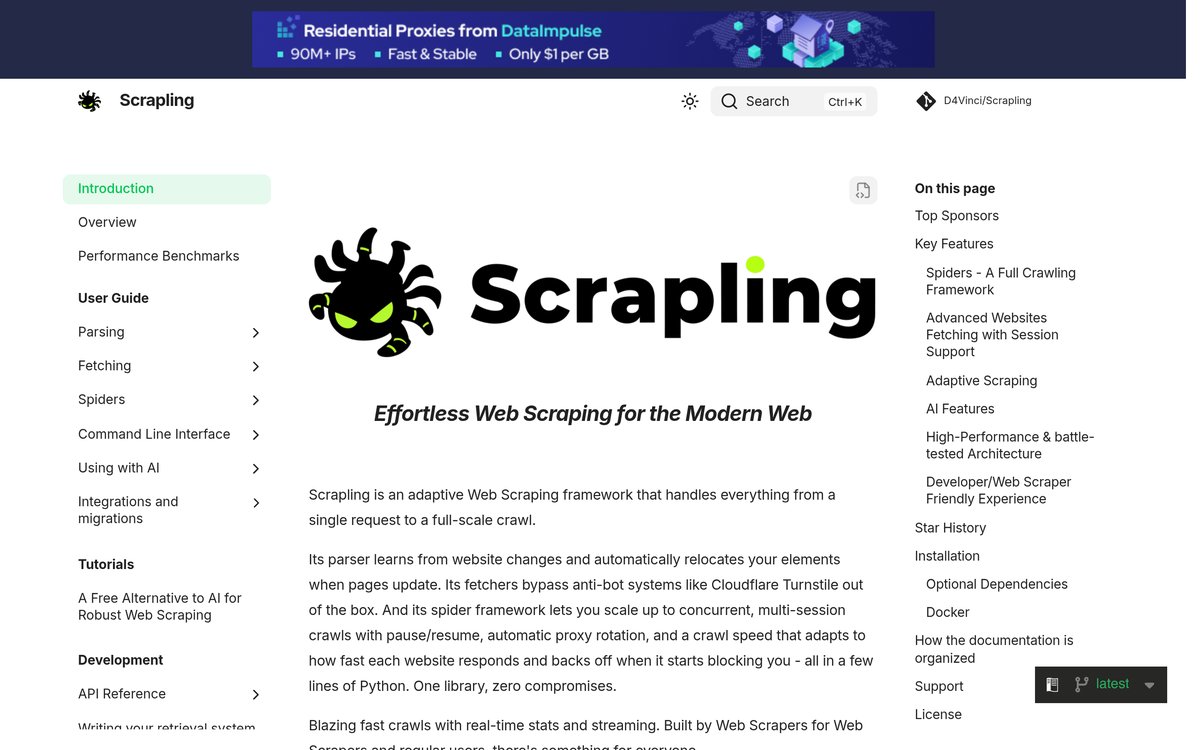
常规做法是用 CSS 选择器或 XPath 定位元素,一旦对方调整 DOM 结构,选择器就全部落空。Scrapling 的 Adaptive Scraping 能力针对的正是这种失效场景——它保留对元素特征的记忆,页面结构发生变化时仍能重新定位到目标内容。对于需要长期运行、目标站点又频繁改版的抓取任务,这能省下大量反复调试选择器的时间。
配合 AI Features 与可选的 Optional Dependencies,它把一些需要额外模型或依赖的判断环节也纳入框架内部,而不是让使用者自己去拼装第三方库。是否启用取决于具体任务,属于按需加载的设计。
规模化抓取涉及的那几个动作
单次请求和全站爬取之间的差距,主要落在几个工程细节上。Scrapling 在这几处都有对应能力:
| 能力 | 解决的具体问题 |
|---|---|
| Concurrent Crawling | 并发发起请求,缩短大批量页面的整体抓取耗时 |
| Multi-Session Support | 用多个会话分别维持不同的登录态或 Cookie 上下文 |
| Pause & Resume | 中断后从断点继续,不必从头重跑整轮任务 |
| Streaming Mode | 边抓边处理,不用等全部结果落盘再统一解析 |
| Docker | 以容器方式部署,减少环境依赖带来的差异 |
这几项放在一起看,指向的是同一件事:让抓取任务可以被中断、被恢复、被并行推进,而不是一个必须一口气跑完的黑盒脚本。Pause & Resume 对长时间运行的爬取尤其关键,网络波动或机器重启不再等于前功尽弃。Multi-Session Support 则让需要区分身份的场景变得直接,不必在代码里手工管理一堆请求头。
几个具体的落地用法
监控类任务是最能体现自适应价值的场景。目标站点每隔一段时间调整一次页面布局,用固定选择器写的脚本通常一改就崩;Scrapling 的自适应定位能在这类反复改版中保持抓取连续性,维护成本从”每次改版都要重写”降到”偶尔检查”。
需要登录态的数据采集适合用多会话加断点续爬的组合。把不同账号或不同权限的会话分开,各自维持独立上下文;任务中途中断后从断点接续,不必重新走一遍登录和翻页流程。流式模式则适合结果量大、希望边抓边写入数据库或消息队列的情形,内存占用比先攒后处理更可控。
部署环节用 Docker 打包,能把 Python 版本、依赖冲突这类常见问题挡在环境之外,团队内不同机器跑同一份任务时行为更一致。整个框架以 Python 语言实现,接入现有数据处理流程不需要额外的语言桥接。
该不该用它
Scrapling 面向的是需要长期维护、规模会增长的抓取需求,而不是临时抓一个页面的小脚本。任务简单、目标页面一次成型、跑完就丢的场合,用 requests 加解析库就够了,引入框架反而增加理解成本。反过来,抓取任务会反复运行、目标站点会改版、需要并发和断点恢复的,Scrapling 提供的这些能力都是直接可用的,不用自己从零搭一套调度与状态管理。它在开源抓取框架里属于功能覆盖较全的一档,代价是上手时需要先理解自适应、会话、流式这几个概念之间的关系。
FAQ:常见问题
Scrapling 的自适应抓取和普通 CSS 选择器有什么区别?
普通选择器依赖固定的 DOM 路径,页面结构一变就失效。Scrapling 的 Adaptive Scraping 会保留元素特征记忆,在页面改版后仍能重新定位目标内容,减少反复修改选择器的工作量。
Scrapling 支持中断后继续抓取吗?
支持。它提供 Pause & Resume 能力,任务中断后可以从断点继续,不必从头重跑整轮爬取。配合 Multi-Session Support 和 Concurrent Crawling,适合长时间运行、需要并发推进的抓取任务。
相关文章
AI迅搜
找工具,快人一步